CLUSTER_MODE 与 CLUSTER_ID
指定服务器独立运行,还是作为集群成员运行。集群 ID 相同的服务器会自动组成一个集群,并自行选举出作业调度器。无论租户主目录是共享还是各自独立,作业都会被分派到最合适的成员。
MTGPU 自动配置账户,并为位于任何地点的服务器提供内置的原生与容器化作业调度。只需简单配置,即可从单台服务器扩展到集群——无需部署独立的调度系统或目录服务。
MTGPU Server
MTGPU 只需一份简单配置,就能把现有工作站或云主机变成多租户集群。几分钟即可完成安装,集群自动组成,用户账户在首次访问时自动开通,无需管理员逐一设置。内置作业调度器同时支持原生作业和容器作业,并自动故障切换——无需另外安装和维护独立的调度系统。从单台服务器到数千台的集群,安装方式和使用体验始终相同。需要时增加电脑或共享存储即可;用户文件的所有权在每台服务器上保持一致,无需迁移账户或数据。
每台计算机一份文件
MTGPU 通过一份配置文件来安装和管理每台计算机。少数几个设置就定义了计算机各自如何工作、又如何协同工作:
CLUSTER_MODE 与 CLUSTER_ID指定服务器独立运行,还是作为集群成员运行。集群 ID 相同的服务器会自动组成一个集群,并自行选举出作业调度器。无论租户主目录是共享还是各自独立,作业都会被分派到最合适的成员。
TENANT_HOME_ROOT指定账户主目录的根目录。MTGPU 为租户账户分配在所有服务器上唯一且一致的 UID/GID,从而可以无缝共享主目录。
已有的操作系统账户及其主目录继续照常工作,不受影响。
CONTAINERS.enabled启用容器工作区。配套设置指定预选的工作区模板、从私有仓库预拉取的镜像、持久化缓存卷、网络访问与端口发布策略,以及是否允许用户使用自带镜像。
DATASETS_DIRECTORIES 和 PYTHON_INTERPRETERS 以只读方式向所有账户发布数据集和 Python 环境。USER_DISK_LIMIT、JOB_RETENTION_DAYS 和 TENANT_RETENTION_DAYS 分别指定每位用户的磁盘配额、已完成作业记录和数据的保留天数,以及不活跃账户的保留天数。MTGPU 执行这些策略,无需管理员干预。
几分钟即可就绪。同一份配置文件可以复制到多台计算机使用,必要时只需少量修改。安装完成后,集群自动组成,获得授权的用户即可从互联网上的任何地方开始访问和工作。无需再安装和管理任何其他系统:不需要 Slurm、Kubernetes 之类的调度系统,也不需要 LDAP、NIS 之类的目录服务。MTGPU 目前支持 Linux 和 Windows WSL2。
多租户共享,无需复杂管理
每位授权用户都有私有的非特权操作系统账户。需要时可以随时添加新的计算机和共享存储,用户文件的所有权自动延续到每一台服务器。
单个开发者可以把它安装在工作站上,然后用笔记本电脑在任何地方工作。一组开发者可以把各自的工作站组成一个集群。每台主机都受到保护:成员以非特权租户账户工作,主目录彼此私有;在 Windows WSL 主机上,mtgpu-setup 默认将本机磁盘对租户隔离。
交互式开发或作业执行
MTGPU 默认使用 Podman 运行无 root 权限的容器。每个容器都在工作区中以用户自己的账户身份运行,并挂载用户主目录和持久化缓存卷。计算资源在创建工作区时预留。
工作区可来自管理员预选的模板、从私有仓库预拉取的镜像、公共 OCI 镜像、由您自定义工作区保存的镜像,或采用标准 Docker 容器规范的 devcontainer.json。
GPU 可见性、挂载和生命周期均由 MTGPU 管理,并按您的选择发布端口——Jupyter、TensorBoard 或您自己的 Web 界面一键即达。
手动创建工作区用于交互式开发:在其中打开终端,或将 Microsoft 的 Dev Containers 扩展连接到该工作区。容器化作业会根据作业规范自动创建工作区,并在作业结束后自动移除。
断线不断会话
每个 SSH 终端都运行在 GPU 主机上的 tmux 会话中,断开连接后会话仍会保留。Claude Code、Codex CLI 等工具中的 AI 编程会话和智能体任务会继续运行,训练循环以及交互式 Python 或调试器会话也一样。
mtgpu-setup 安装在 GPU 主机上,客户端自动接入。内置集群调度
集群作业提交实现高效的资源共享:调度器要么立即在可用节点上运行作业,要么把作业排入队列,等到有节点空出来再运行。MTGPU 同时支持原生作业和容器化作业。原生作业的命令在用户主目录环境中执行;容器化作业的命令在容器环境中执行,并挂载用户主目录和持久化缓存卷。作业写在一个类似 Slurm 批处理脚本的文件中:可选的容器、所需资源——GPU、CPU、最低显存和内存——以及要执行的命令。
GPU 预留有三种模式:独占、在保证显存容纳的前提下共享、或以超配方式机会共享。作业可以按类型预留 GPU,例如 nvidia:1、amd:2 或 rtx4090:1,也可以用 server=<服务器名> 指定服务器。
仅配备 CPU 的服务器也可以加入集群,承接不需要 GPU 的作业。
每个节点实时报告实测的 GPU、显存、CPU 和内存用量。调度器同时依据实测空闲容量和已承诺容量,把作业放到最合适的节点。所有合适的节点都繁忙时,作业按优先级进入队列;等待时间越长,优先级会逐步提升,确保低优先级作业最终也能运行。整个集群都不可能满足的请求会被立即拒绝。
分布式训练需要同时使用多台 GPU 服务器。作业文件中写入 nodes=N,同一命令即在 N 个节点上运行:每个节点通过环境变量获得自己的 rank 和汇合地址,可直接用于 torchrun 或任何基于 NCCL 的启动器;整组作业要么一起启动,要么都不启动,任一节点失败则其余节点一并停止。对于每次运行相互独立的工作,array= 把一个文件展开为多个独立作业,每个索引一个,分散到有空闲的节点上执行。
这两个指令在原生作业和容器化作业中都受支持。
集群节点自动选举能力最强的节点担任调度器,并持续复制其队列。调度器节点离线时,另一节点自动接管,作业无需重新提交。
随着集群扩大,调度器仍能高效运行。在模拟负载测试中,以一台 2012 年桌面 CPU(AMD FX-8350)作为基准下限,其上的调度器即可从容应对一千个节点和数千个租户账户,仍有余量;使用当前硬件,上限还会更高。
支持主流 GPU 品牌。MTGPU 自动检测每台机器上的 GPU,NVIDIA、AMD 和 Intel GPU 开箱即用;其他品牌会自动完成配置和测试,几乎无需管理员介入,详见用户手册。
两种存储布局都支持。采用共享主目录存储时,用户的主目录在每台计算机上都是同一个,容器化作业的容器镜像只需归档一次,由实际运行作业的节点从同一存储中取回。采用独立主目录存储时,作业首次在某节点上执行时,调度器会把镜像传送到该节点。
多集群。管理员可以在同一个管理员账户下运行多个集群——例如按团队、站点或硬件代际各建一个——每个集群拥有自己的集群 ID 和调度器。使用 mtcode-admin 将用户分配到不同的集群:用户只能看到并向获得授权的集群提交作业,一个用户也可以同时获得多个集群的授权。
兼容现有工具。MTGPU 不会把机器封闭起来:您的工作流程已经依赖的外部工具可以照常与 MTGPU 并行使用,无需任何改变。
在租用的云 GPU 或 VPS 上无界面安装。MTGPU 的安装和运行完全无需显示器,只要一个 SSH 终端即可。用 scp 把安装包复制到主机,或直接在 SSH 会话中下载,然后运行 mtgpu-setup install --yes 完成无人值守安装,并启用开机自动启动。
适应用户的工作方式
既可在 VS Code 中使用 MTGPU,也可从终端使用,支持 Windows、macOS 和 Linux。两个客户端发现同一批获得授权的服务器,并提供相同的核心访问和工作区操作。
发现服务器、比较实时使用率并创建交互式工作区。随后打开 SSH 终端,或启动 Microsoft 的 Remote - SSH 或 Dev Containers 扩展,并在同一面板中跟踪作业状态。该扩展可在 VS Code 中从 Visual Studio Marketplace 安装。
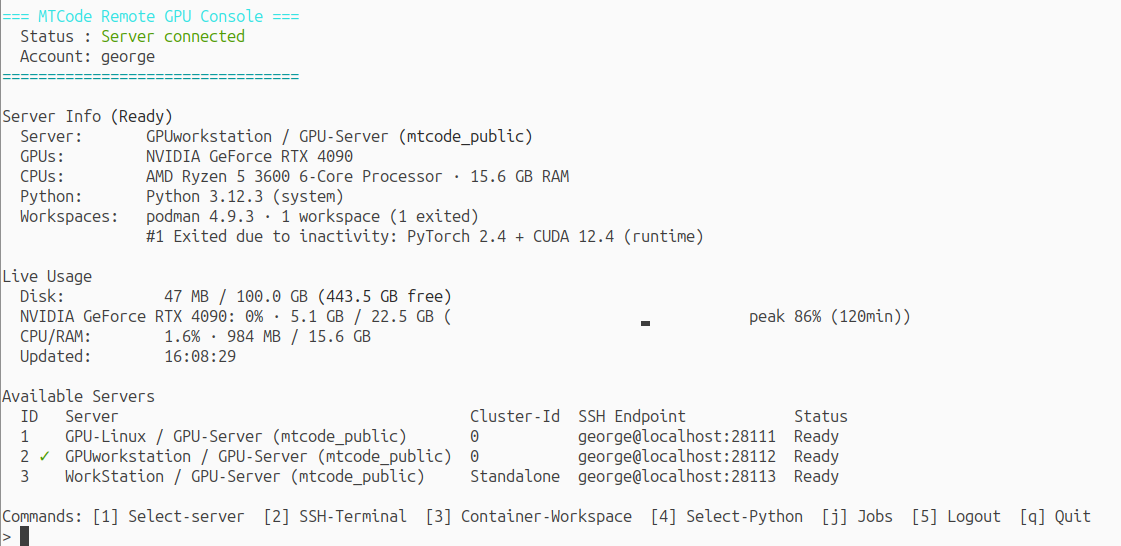
无需 VS Code,通过键盘驱动的终端程序获得相似的服务器发现、实时使用率、SSH 访问、工作区管理和作业状态功能。remotegpu-cli 包含在 MTCode Portal 软件包中。
两种客户端通用的终端工具。无论 SSH 终端是从 VS Code 还是 remotegpu-cli 打开,用户都可以用 mt-job、mt-container、mt-podman 和 mt-python 管理自己的工作流;管理员则在服务器终端上用 mtgpu-admin 监控和管理服务器与用户。